Robots.txt es un archivo de texto ubicado en la raíz de un host que indica a rastreadores compatibles qué rutas pueden solicitar. Su función principal es administrar rastreo, no sacar páginas del índice ni proteger información. Una URL bloqueada puede aparecer en resultados si otros sitios la enlazan; para contenido privado corresponde autenticación, y para excluir una página rastreable puede corresponder noindex.
Una sola línea mal aplicada puede cerrar una sección o todo el sitio a un buscador. Por eso robots.txt debe tratarse como configuración de producción: con objetivo, propietario, pruebas, historial y plan de recuperación.
Qué es el archivo robots.txt
Implementa el Robots Exclusion Protocol. Agrupa reglas para uno o varios agentes y patrones de ruta. Los buscadores reconocidos suelen respetarlas, pero un actor malicioso puede ignorarlas. El archivo es público y cualquiera puede leer las rutas mencionadas.
Si no existe una regla que bloquee una URL, el acceso se considera permitido. Tener un archivo vacío o una regla Allow: / no mejora posicionamiento; solo hace explícito el acceso.
Dónde debe estar y a qué aplica
Se sirve como https://ejemplo.com/robots.txt. No funciona en /carpeta/robots.txt. Su alcance se limita a protocolo, host y puerto: el archivo de www no controla un subdominio, y HTTPS no hereda reglas desde HTTP.
Cada host relevante necesita su decisión. Comprueba dominio canónico, subdominios, staging y CDN. El archivo debe responder públicamente y en texto UTF-8; redirecciones y errores HTTP pueden alterar cómo se interpreta.
Sintaxis básica
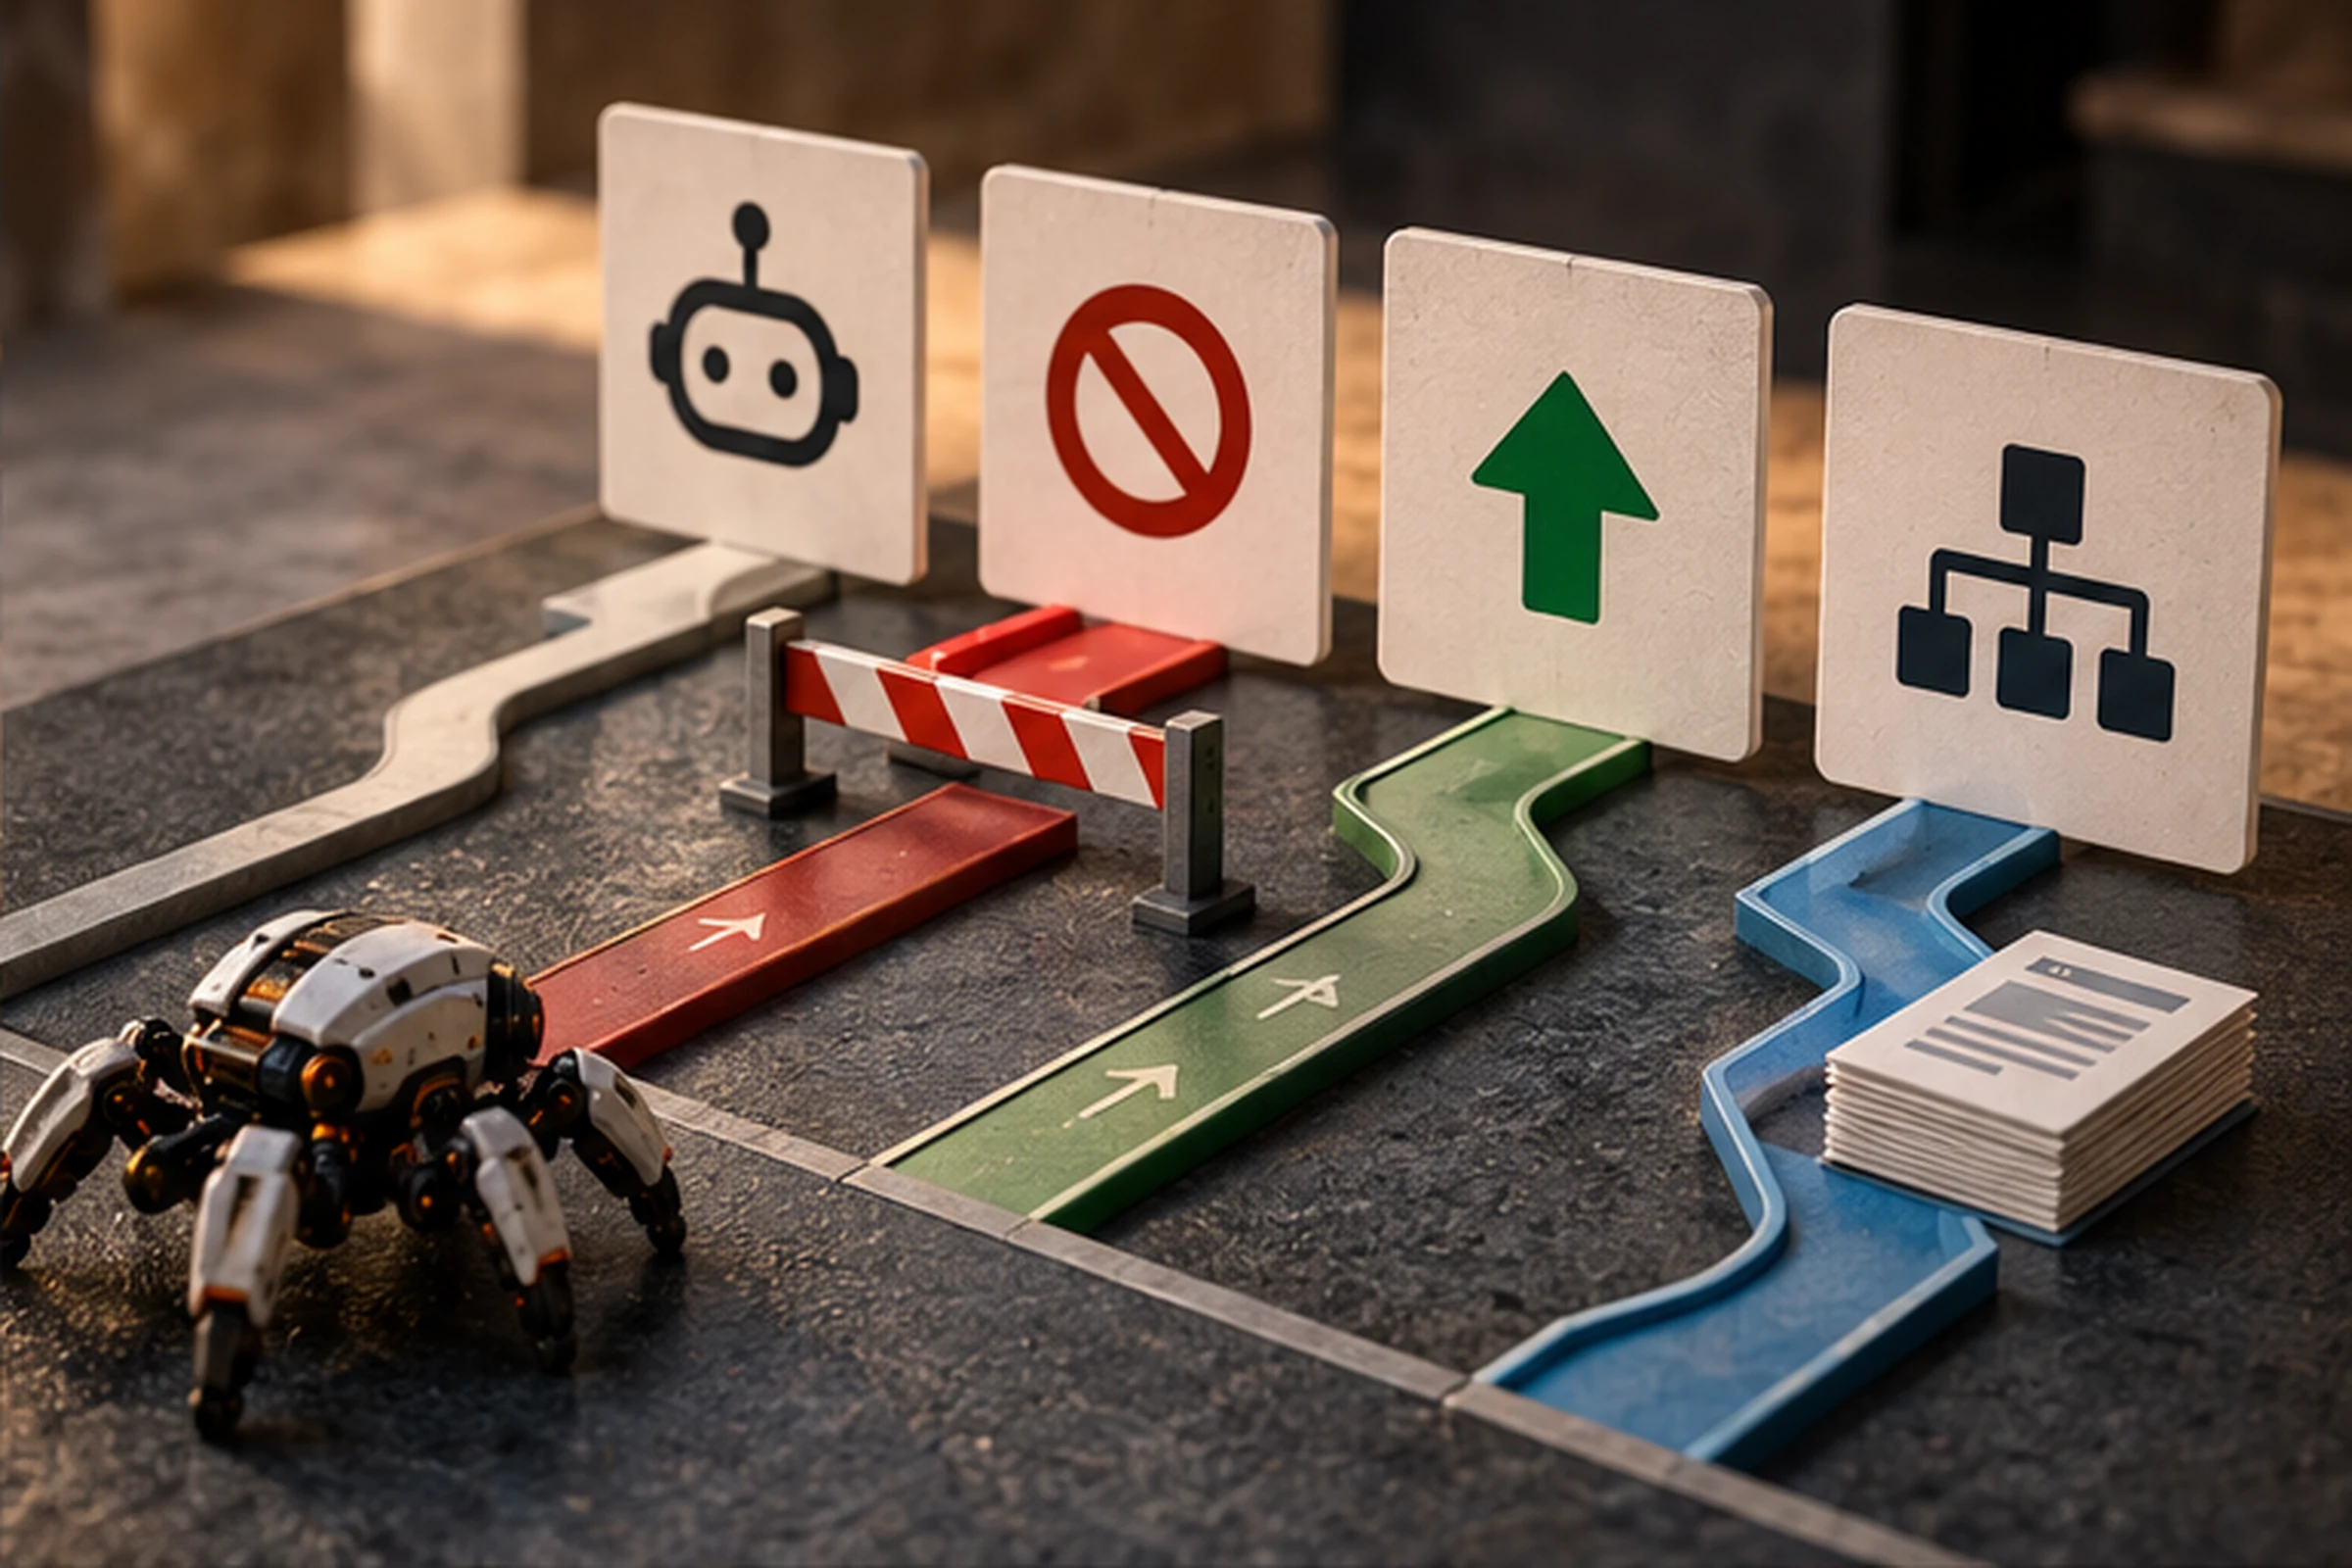
User-agent inicia un grupo. Disallow restringe una ruta; Allow puede abrir una excepción dentro de un patrón bloqueado. Sitemap declara una URL absoluta del sitemap. El carácter # inicia un comentario.
Las rutas distinguen mayúsculas y minúsculas. Google admite comodines definidos en su documentación, pero otros rastreadores pueden interpretar de forma distinta. Diseña primero para el estándar y valida con los agentes prioritarios.
Ejemplo mínimo comentado
User-agent: *
Disallow: /busqueda-interna/
Allow: /
Sitemap: https://www.ejemplo.com/sitemap.xml
El ejemplo permite el sitio y bloquea una ruta concreta. No debe copiarse sin revisar arquitectura. Si el buscador interno produce páginas útiles o la ruta cambia, la regla tendría otro efecto.
Allow: / es redundante cuando no hay un bloqueo más amplio. La claridad importa: pocas reglas justificadas son más seguras que una colección histórica sin propietario.
Rastreo no es indexación
Rastrear significa solicitar un recurso. Indexar significa procesarlo para que pueda aparecer en búsqueda. Robots.txt controla el primer paso. Google advierte que una URL bloqueada aún puede indexarse sin descripción si se descubre mediante enlaces.
Si necesitas retirar una página pública de resultados, permite rastreo y entrega noindex hasta que se procese, o retírala con un estado adecuado. Si contiene información privada, exige autenticación; no confíes en una instrucción voluntaria.
Robots.txt no canonicaliza
Una canonical necesita que el buscador pueda leer el HTML o la cabecera. Bloquear la variante puede impedir procesar esa señal. Para duplicados usa etiqueta canonical, redirecciones, enlaces consistentes y sitemap según el caso.
Robots puede reducir acceso a espacios de bajo valor, pero no reemplaza arquitectura. Primero evita generar combinaciones infinitas y luego controla lo inevitable.
Robots.txt no es seguridad
El archivo anuncia públicamente rutas y no obliga a todos los clientes. Paneles, documentos y ambientes privados requieren autenticación, autorización y configuración del servidor. Quitar una ruta del archivo no la hace secreta.
Comprueba también backups, almacenamiento y URLs compartidas. Si hubo exposición, corrige acceso y evalúa el incidente; editar robots no revoca copias ni enlaces existentes.
CSS, JavaScript e imágenes
Bloquear recursos necesarios puede impedir que un buscador renderice y entienda la página. No bloquees carpetas completas de temas o scripts sin comprobar qué consumen las plantillas. Google recomienda permitir recursos relevantes para representación.
Para imágenes o video, las reglas pueden influir en rastreo del archivo y visibilidad del recurso, pero la página contenedora es otro objeto. Separa objetivos y prueba ambos.
Parámetros, filtros y ecommerce
Los ecommerce generan orden, filtros, búsqueda y seguimiento. Clasifica cada parámetro por cambio de contenido, demanda y enlaces. Robots puede restringir espacios enormes, pero si ya están indexados el bloqueo puede congelar señales antiguas.
Reduce generación, normaliza URLs y enlaza facetas seleccionadas. Alinea canonical, sitemap y navegación. No uses una regla global para toda URL con ? sin revisar paginación y funciones legítimas.
Robots.txt en WordPress
WordPress puede generar un archivo virtual y plugins SEO pueden modificarlo. Revisa el resultado público, no solo el editor. La opción de disuadir motores de búsqueda puede producir un bloqueo amplio o meta robots, según versión y configuración.
En producción verifica después de migrar, clonar o cambiar dominio. Staging debe protegerse con acceso, no únicamente con robots. Nunca reemplaces archivos del servidor sin saber si existe una capa virtual o CDN.
Cuándo un bloqueo puede ser útil
- Búsquedas internas sin valor indexable.
- Combinaciones técnicas que generan espacios enormes.
- Endpoints o recursos prescindibles para rastreo compatible.
- Parámetros de navegación sin contenido distintivo, evaluando estado previo.
- Áreas de administración, como complemento y no como seguridad.
El beneficio se evalúa frente al riesgo de ocultar recursos, enlaces o señales. En sitios pequeños, un robots complejo rara vez compensa.
Errores de sintaxis y alcance
Un Disallow: / bloquea todo para el grupo. Una barra ausente puede cambiar alcance. Las reglas son sensibles a mayúsculas. Grupos repetidos, espacios y directivas no soportadas generan suposiciones equivocadas.
Otro error es editar el archivo del host incorrecto o probar con sesión administrativa que pasa por una ruta distinta. Recupera siempre la URL pública exacta y observa estado, contenido y cabeceras.
Cómo auditar robots.txt
- Descarga archivos de cada host y protocolo relevante.
- Registra estado HTTP, redirección y contenido.
- Enumera agentes y grupos.
- Prueba URLs estratégicas y patrones.
- Compara con rastreo, sitemap y enlaces.
- Revisa recursos de renderizado.
- Relaciona reglas con un objetivo documentado.
- Elimina o corrige por cambio controlado.
Una auditoría SEO debe probar páginas reales: portada, categorías, productos, artículos, paginación, idiomas, recursos y rutas sensibles.
Cómo desplegar un cambio seguro
Guarda copia, explica objetivo y prepara pruebas antes/después. Evalúa primero en un entorno que no pueda afectar producción, pero recuerda que el host de staging tiene su propio alcance. Programa observación de logs y Search Console.
Después de publicar, solicita /robots.txt sin caché, prueba URLs y confirma que CDN y servidor entregan la versión nueva. Google puede conservar una copia temporal; usa los mecanismos oficiales cuando corresponda y monitorea.
Qué hacer ante un bloqueo accidental
- Confirma el archivo público y el agente afectado.
- Identifica cambio, alcance y hora.
- Restaura una versión conocida o corrige la regla.
- Purga solo la caché necesaria.
- Verifica desde fuera y prueba URLs.
- Revisa informe de robots e inspección.
- Monitorea rastreo e indexación.
- Documenta causa y prevención.
Qué medir
Observa solicitudes por agente y sección, errores, páginas bloqueadas importantes, recursos no rastreados e indexación de URLs conocidas. Cambios de tráfico no se atribuyen automáticamente a robots; relaciona fecha, patrón y evidencia.
En sitios grandes analiza logs. En todos, conserva pruebas canónicas. La meta no es “bloquear más”, sino facilitar que el rastreo permitido encuentre contenido útil sin sobrecargar sistemas.
Qué ocurre cuando el archivo falla
El comportamiento puede variar según el estado HTTP y el tiempo de la falla. Una respuesta correcta debe entregar el archivo previsto; un 404 suele interpretarse como ausencia de restricciones, mientras errores del servidor pueden provocar cautela temporal. Consulta la documentación vigente del rastreador para cada caso.
No diseñes disponibilidad SEO alrededor de una suposición. Monitorea el endpoint, conserva una versión mínima segura y evita que robots dependa de una aplicación inestable. Una redirección entre hosts también puede dejar reglas fuera de alcance aunque el navegador muestre contenido.
Agentes y grupos específicos
Un grupo para * cubre agentes compatibles no tratados de forma más específica. Si creas grupos particulares, comprueba las reglas que realmente se combinan o seleccionan. No asumas que escribir el nombre de una empresa abarca todos sus rastreadores.
Documenta por qué un agente recibe trato distinto, quién pidió el cambio y cómo se evaluará. Bloquear rastreadores de herramientas puede afectar auditorías; permitir clientes activados por usuarios puede tener otra implicación. Los nombres y comportamientos evolucionan, así que revisa referencias oficiales.
Validación con logs del servidor
Los logs muestran solicitudes reales, agente declarado, ruta, respuesta y tiempo. Úsalos para detectar espacios de rastreo, errores y cambios después de una regla. Recuerda que el agente declarado puede falsificarse; para análisis sensible verifica IP o mecanismos documentados por el proveedor.
Agrupa por plantilla y patrón, no por URL aislada. Compara periodos equivalentes y conserva el efecto del caché. Una reducción de solicitudes puede ser el objetivo, pero confirma que contenido importante sigue siendo descubierto y actualizado.
Coordinación entre SEO, desarrollo y seguridad
SEO define qué contenido necesita rastreo; desarrollo conoce rutas y recursos; seguridad controla acceso real. Ningún equipo debería usar robots para resolver el objetivo del otro. Incluye el archivo en revisión de código o en un proceso de cambio equivalente.
Cuando una campaña crea parámetros o una plataforma cambia rutas, avisa antes del lanzamiento. Mantén un diccionario de patrones con ejemplo, finalidad, responsable y regla esperada. Esta disciplina reduce bloqueos accidentales y reglas obsoletas.
Programa una revisión después de migraciones y grandes actualizaciones. Compara la versión guardada con la pública y alerta cambios no autorizados. Si un proveedor administra el archivo, documenta el canal de emergencia y el tiempo esperado de corrección; un incidente fuera de horario no debe depender de localizar a una sola persona.
Checklist antes de guardar
- Archivo en raíz del host correcto.
- Respuesta pública y texto UTF-8.
- Ningún bloqueo de páginas estratégicas.
- Recursos críticos permitidos.
- Objetivo correcto: rastreo, no seguridad.
- Sitemap absoluto y canónico.
- Pruebas por agente y patrón.
- Copia, propietario y monitoreo.
Si detectas un conflicto crítico, no añadas más reglas sin mapa. Puedes contactar a SEOMOS para revisar arquitectura y recuperación.
Fuentes consultadas
Documentación consultada el 10 de septiembre de 2026.
- Google: introducción a robots.txt.
- Google: crear y probar robots.txt.
- RFC 9309: Robots Exclusion Protocol.
Preguntas frecuentes sobre robots.txt
¿Qué hace robots.txt?
Indica a rastreadores compatibles qué rutas pueden solicitar en un host.
¿Evita que una página aparezca en Google?
No necesariamente. Una URL bloqueada puede indexarse si se descubre por enlaces.
¿Protege información privada?
No. Usa autenticación y autorización; el archivo es público y su cumplimiento es voluntario.
¿Dónde se ubica?
En la raíz de cada protocolo, host y puerto al que debe aplicar.
¿Debo incluir el sitemap?
Puede declararse con una URL absoluta; también puede enviarse mediante Search Console.
¿Cómo pruebo un cambio?
Comprueba el archivo público y prueba URLs reales por agente antes y después del despliegue.