noindex, detecta otra URL canónica, decide no incorporarla al índice o sí la tiene indexada, pero no la considera suficientemente relevante para la búsqueda que realizas. El orden correcto es revisar robots.txt y el sitemap XML, conectar Google Search Console, inspeccionar la URL y corregir la causa exacta antes de solicitar indexación.Publicar una web no significa que aparecerá automáticamente cuando alguien busque tus productos o servicios. Antes de mostrar una página, Google debe descubrir la URL, poder rastrearla, procesar su contenido, decidir si la incorpora al índice y, después, compararla con otras páginas para cada consulta.
Por eso la pregunta “¿por qué mi página web no aparece en Google?” puede describir dos problemas diferentes: la página no está indexada o está indexada, pero no posiciona para las palabras que usa tu cliente. Configurar robots, sitemap y Search Console ayuda a resolver y medir la primera situación; una estrategia SEO recurrente trabaja también la segunda.
Primero confirma si es indexación o posicionamiento
Haz una comprobación orientativa en Google con site:tudominio.com. También puedes buscar la URL completa o el nombre exacto de la marca. Si aparecen páginas del sitio, Google conoce al menos parte del dominio. Si la web aparece por la marca, pero no por consultas como “abogado laboral en Bogotá” o “software contable para pymes”, el problema principal ya no es estar en el índice: es competir por esas búsquedas.
La prueba site: no es un inventario completo ni sustituye los datos de Search Console. Para diagnosticar una URL específica, utiliza Inspección de URL; para entender el conjunto del sitio, revisa el informe de Indexación de páginas.
| Situación | Qué significa | Primer paso |
|---|---|---|
| No aparece ninguna URL | Google puede no conocer el sitio o tener un bloqueo general. | Revisar robots, noindex, sitemap y propiedad en Search Console. |
| Aparece la portada, pero no páginas internas | Puede fallar el descubrimiento, el enlazado, el sitemap o la indexabilidad de esas páginas. | Inspeccionar una URL interna concreta. |
| Aparece por marca, no por servicios | El sitio está indexado, pero todavía no es competitivo para esas consultas. | Analizar intención, contenido, arquitectura, autoridad y competencia. |
| Aparecía y dejó de hacerlo | Puede existir un cambio técnico, una migración, una caída, una canónica distinta o una pérdida de relevancia. | Comparar fechas, cambios del sitio e informes de Search Console. |
Paso 1: revisa robots.txt y el sitemap XML
Antes de enviar nada a Google, confirma que el buscador puede acceder a las páginas importantes y que el mapa del sitio declara las URLs correctas. Esta revisión evita pedir indexación de una URL que el propio sitio bloquea, redirige o marca como no indexable.
Comprueba el archivo robots.txt
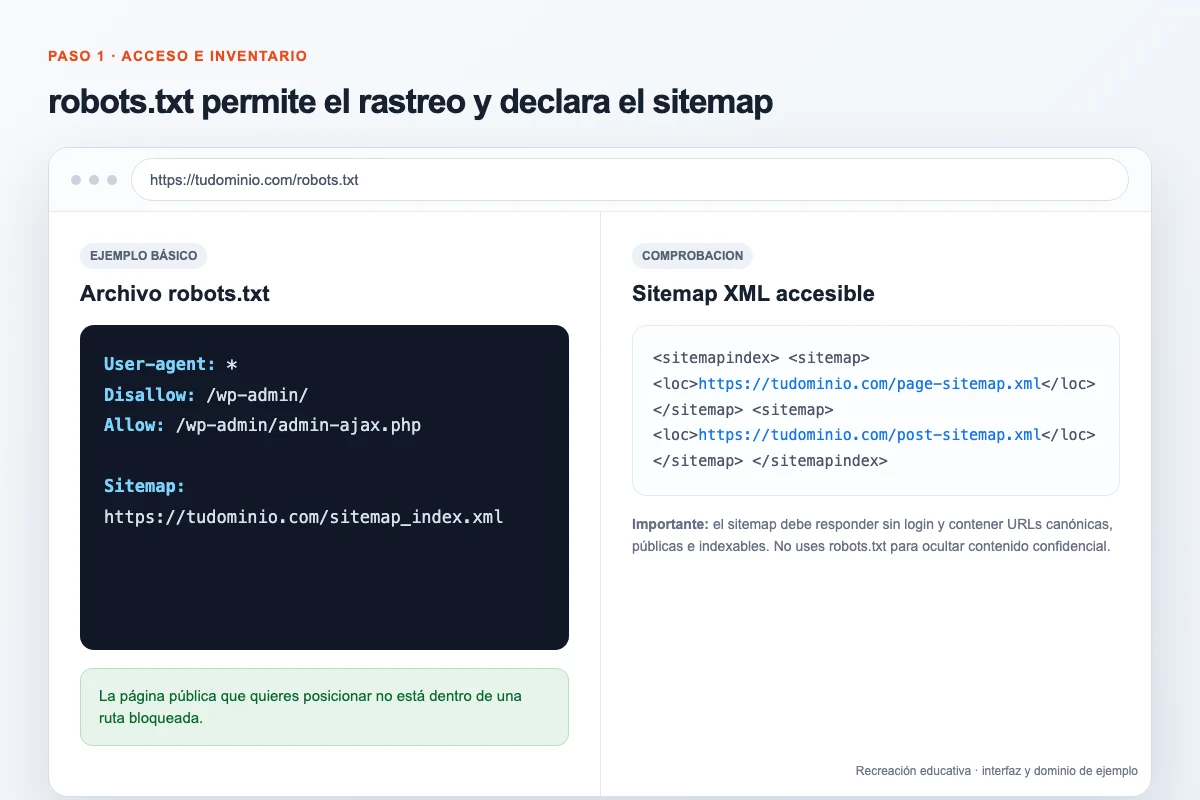
Abre https://tudominio.com/robots.txt. El archivo debe estar en la raíz del host y responder públicamente. robots.txt sirve principalmente para administrar el rastreo; no es el mecanismo adecuado para sacar una página de los resultados. Una URL bloqueada puede llegar a conocerse por enlaces externos, mientras Google no podrá visitar su contenido para leer otras directivas.
En un WordPress típico podrías encontrar una configuración como esta:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://tudominio.com/sitemap_index.xml
No copies este ejemplo sin revisar tu plataforma. Lo importante es que las rutas públicas que deseas posicionar no estén dentro de un Disallow. Evita reglas generales como Disallow: /, habituales en entornos de desarrollo, y no bloquees CSS o JavaScript esenciales si Google los necesita para comprender la página.
Revisa también noindex y la URL canónica
Permitir el rastreo no basta. En el código de la página busca una etiqueta como <meta name="robots" content="noindex"> o un encabezado HTTP X-Robots-Tag: noindex. Si la página debe aparecer, elimina esa directiva en el CMS, plugin SEO o servidor que la genera.
Después confirma el rel="canonical". Una página de servicio normalmente debería señalarse a sí misma como canónica. Si apunta por error a la portada, a una URL de pruebas, a una variante con parámetros o a otro dominio, Google puede elegir esa otra versión como representativa.
Abre y depura el sitemap XML
Prueba las rutas comunes /sitemap.xml y /sitemap_index.xml, o consulta la documentación de tu CMS. En WordPress, plugins como Rank Math o Yoast suelen crear un índice de sitemaps; Shopify, Wix y otras plataformas administradas también pueden generarlo automáticamente.
El sitemap debería incluir solo URLs que cumplan estas condiciones:
- Responden con estado HTTP
200y no exigen iniciar sesión. - Son la versión canónica que quieres mostrar en Google.
- No tienen
noindexni están bloqueadas para el rastreo. - No son redirecciones, errores 404, filtros, búsquedas internas ni duplicados innecesarios.
- Utilizan el protocolo y el host definitivos, por ejemplo HTTPS y la variante correcta con o sin
www.
Error frecuente: agregar la dirección del sitemap en
robots.txtayuda a descubrirlo, pero no corrige las URLs defectuosas que contiene ni obliga a Google a indexarlas.
Paso 2: conecta el sitio con Google Search Console
Google Search Console no es obligatorio para que un sitio aparezca, pero es la herramienta principal para saber qué entiende Google, detectar problemas y solicitar una nueva revisión. La conexión comienza agregando una propiedad y demostrando que controlas el sitio.
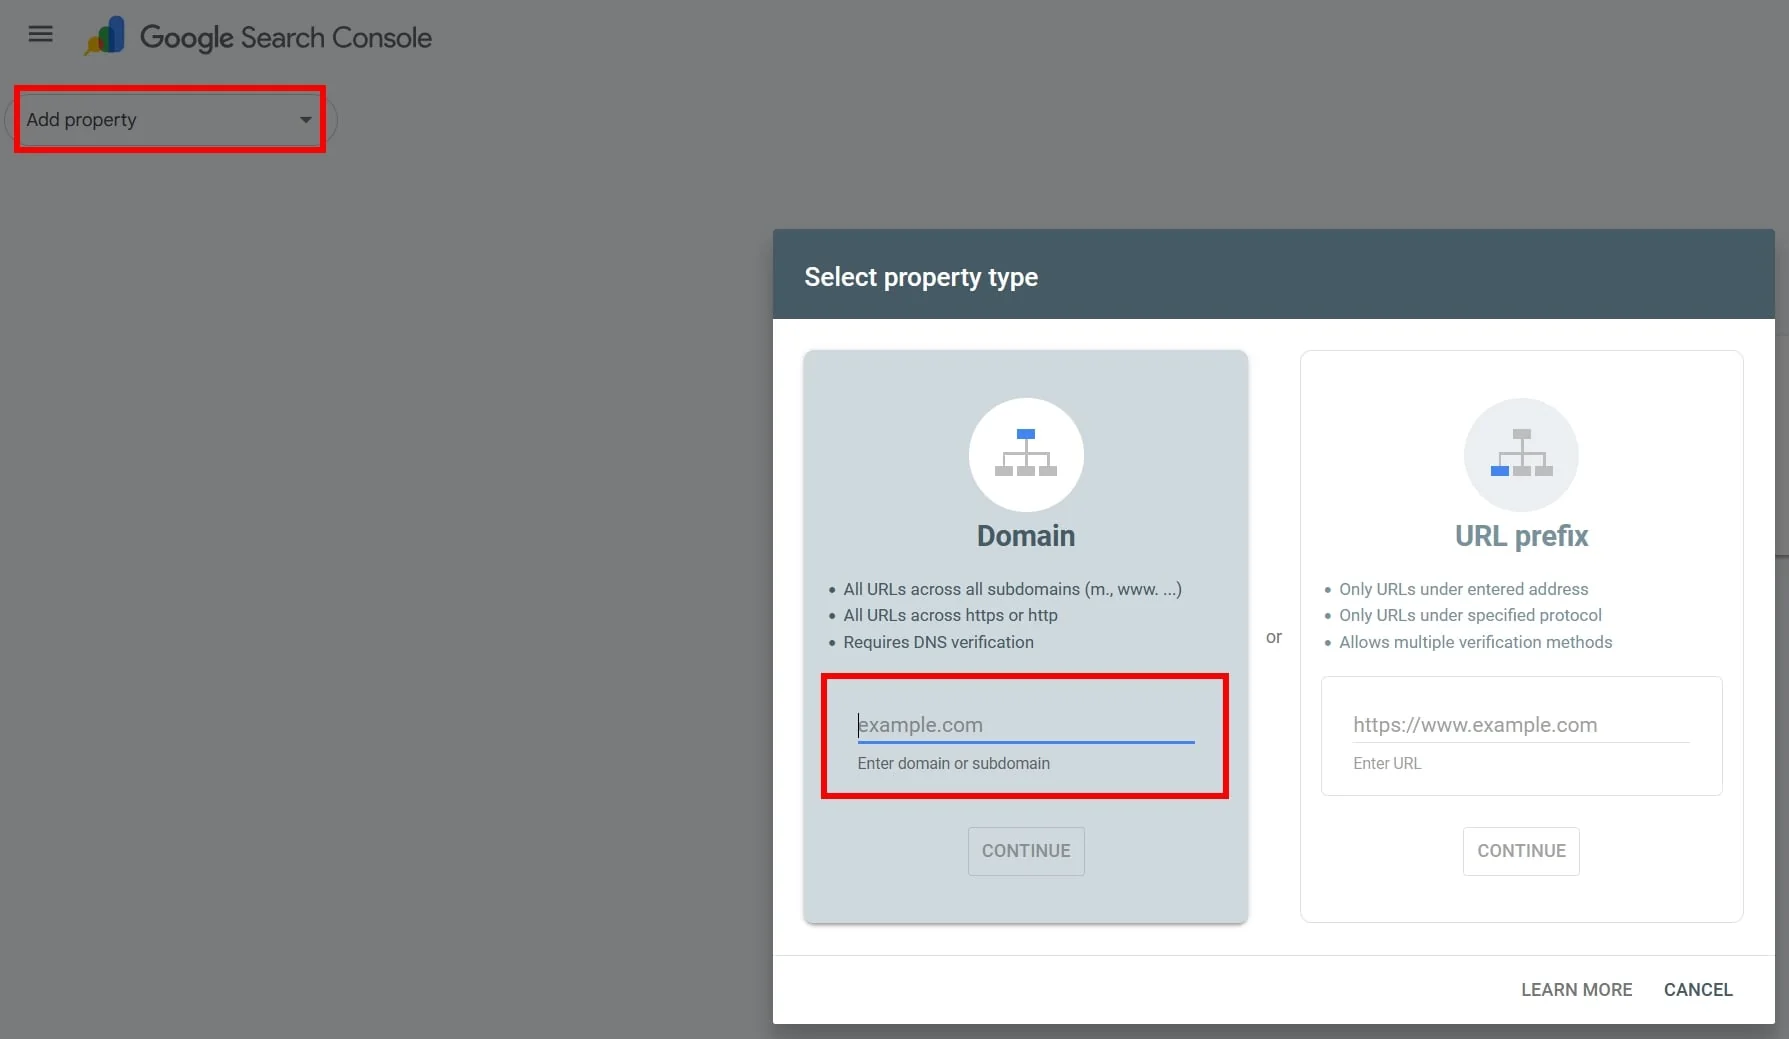
Opción recomendada: propiedad de dominio
- Inicia sesión en Search Console con la cuenta que administrará el proyecto.
- Abre el selector de propiedades y elige Añadir propiedad.
- Selecciona Dominio e ingresa solo el dominio, por ejemplo
tudominio.com, sin protocolo ni ruta. - Copia el registro TXT de verificación que entrega Google.
- En el proveedor DNS del dominio, crea un registro TXT para el host raíz y pega el valor exacto.
- Conserva el registro y vuelve a Search Console para pulsar Verificar. La propagación DNS puede requerir tiempo.
La propiedad de dominio reúne HTTP, HTTPS y los subdominios. Si no tienes acceso al DNS, una propiedad de prefijo de URL permite otros métodos, como un archivo HTML o una metaetiqueta, pero solo cubre el prefijo exacto que agregues. No retires el método de verificación después de conectarlo: Search Console lo vuelve a comprobar periódicamente.
Paso 3: envía el sitemap en Search Console
- Selecciona la propiedad correcta.
- En el menú de indexación, abre Sitemaps.
- En Añadir un sitemap, escribe la ruta exacta, por ejemplo
sitemap_index.xml. - Pulsa Enviar y revisa el estado.
- Si aparece un error, abre el detalle: corrige acceso, formato, host o redirecciones y vuelve a enviarlo.
Un estado correcto significa que Google pudo obtener y procesar el archivo. No confirma que todas las URLs estén indexadas. Para saber qué ocurrió con una página concreta, inspecciona esa URL. Para analizar grupos, usa los filtros del informe de Indexación de páginas.
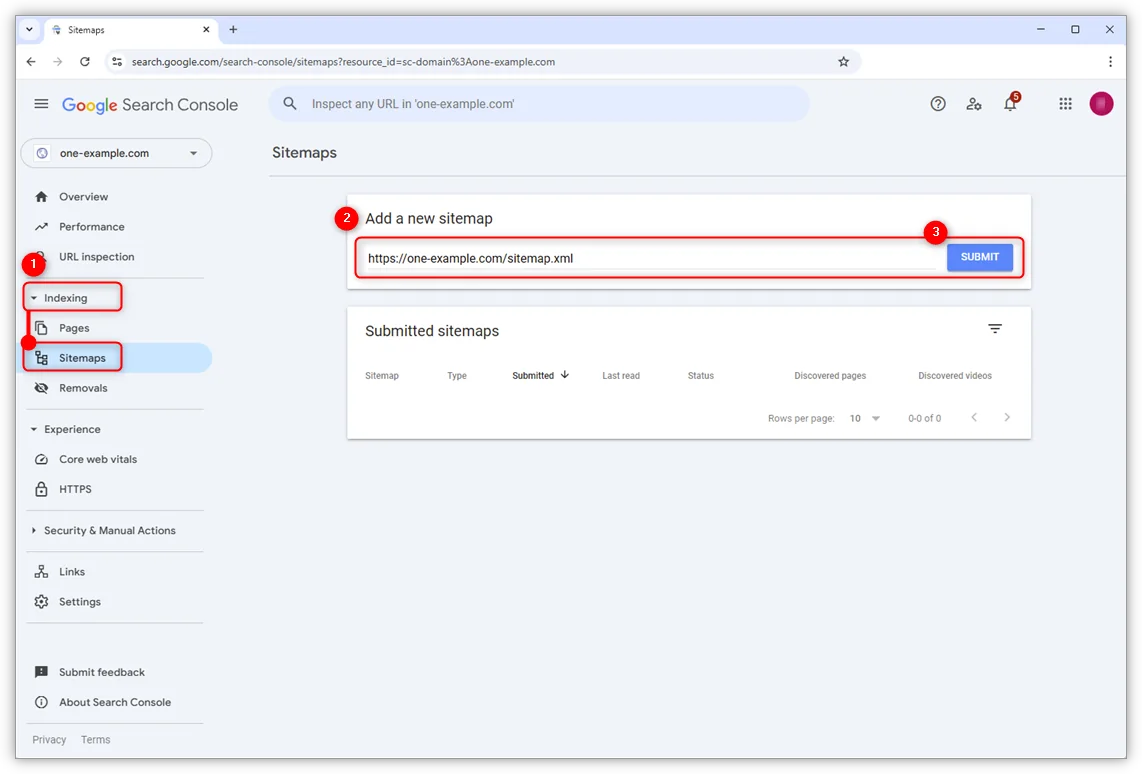
one-example.com. Fuente de la imagen: centro de ayuda de one.com.Paso 4: inspecciona la URL y solicita indexación
La solicitud debe hacerse después de corregir el problema, no como sustituto del diagnóstico. Repetirla sobre una página bloqueada, duplicada o vacía no elimina la causa.
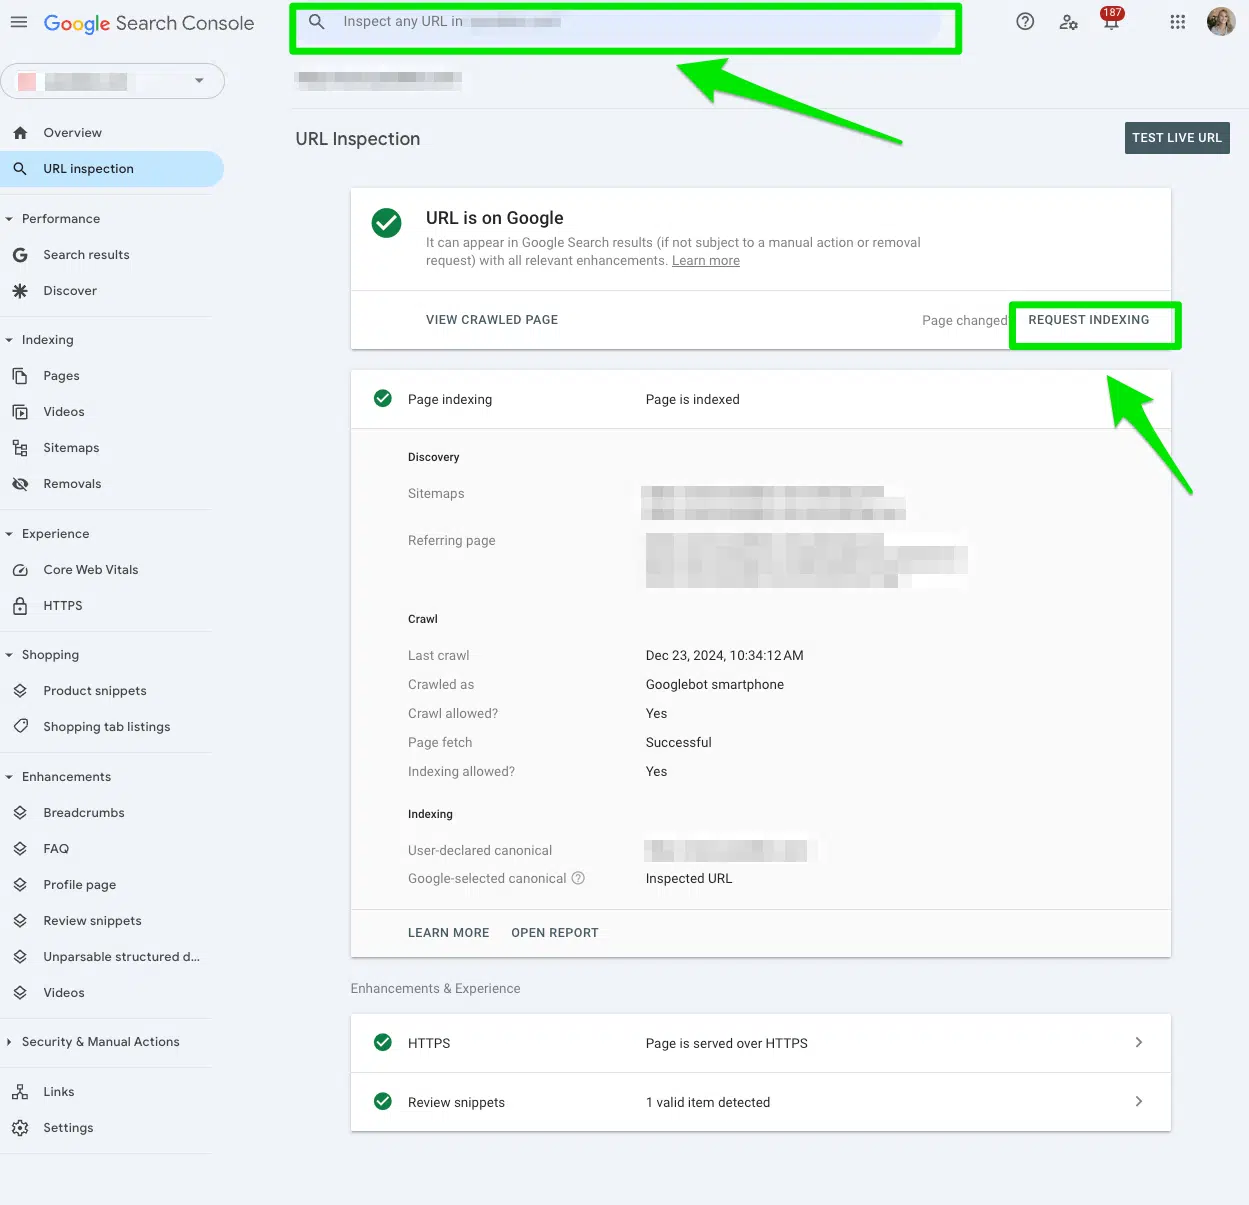
- Copia la URL canónica completa de la página publicada.
- Pégala en la barra superior de Search Console.
- Revisa si la URL está en Google, cuándo fue rastreada y cuál canónica eligió Google.
- Si no está indexada o acabas de corregirla, pulsa Probar URL publicada.
- Comprueba que la obtención sea correcta, que la indexación esté permitida y que el contenido visible sea el esperado.
- Cuando la prueba sea satisfactoria, pulsa Solicitar indexación.
Google puede tardar desde algunos días hasta varias semanas en volver a rastrear una URL, y no garantiza que la incorpore al índice. Reserva las solicitudes para páginas nuevas, cambios importantes o correcciones relevantes. El descubrimiento normal debe sostenerse con sitemaps, navegación y enlaces internos rastreables.
Qué revisar si Google todavía no indexa la página
El informe de Search Console suele mostrar una causa. No todas las exclusiones son errores: una URL de acceso, un filtro o un duplicado puede estar correctamente fuera del índice. La pregunta es si esa URL cumple un propósito de búsqueda y debería competir.
| Estado o señal | Qué revisar | Acción habitual |
|---|---|---|
Excluida por noindex |
Meta robots, plugin SEO o encabezado HTTP. | Retirar noindex solo si la página debe ser pública e indexable. |
| Bloqueada por robots.txt | Reglas para Googlebot y coincidencias de ruta. | Permitir el rastreo y probar de nuevo. No combines bloqueo con un noindex que Google necesita leer. |
| Descubierta, actualmente sin indexar | Enlaces internos, sitemap, capacidad del servidor, duplicación y prioridad real. | Integrar la URL en la arquitectura y mejorar su valor; evitar crear cientos de páginas débiles. |
| Rastreada, actualmente sin indexar | Contenido escaso, repetido, generado a escala o sin propósito diferencial. | Mejorar, consolidar o retirar la URL según la intención que deba resolver. |
| Duplicada o Google eligió otra canónica | Contenido similar, parámetros, protocolo, dominio y señales canónicas contradictorias. | Alinear redirecciones, canonical, sitemap y enlaces internos hacia la versión preferida. |
| Página con redirección | Destino y cadena de redirecciones. | Es normal si fue intencional; incluye en el sitemap y enlaces solo la URL final. |
| Soft 404 | Contenido inexistente, plantilla vacía o página que parece un error aunque responda 200. | Ofrecer contenido útil o devolver el estado HTTP correcto. |
| Error de servidor, DNS o acceso | Estados 5xx, tiempos de respuesta, firewall, CDN y disponibilidad para Googlebot. | Corregir infraestructura y confirmar una obtención correcta en la prueba publicada. |
Si está indexada, ¿por qué no aparece al buscar tus servicios?
Estar indexado solo permite competir. No garantiza una posición visible. Google compara relevancia, utilidad, calidad, contexto, experiencia y otras señales para cada búsqueda. Una página puede aparecer al consultar su URL exacta y permanecer lejos de la primera página para un término comercial disputado.
La página no responde a la intención de búsqueda
Una portada genérica rara vez sustituye una página específica para cada servicio principal. Investiga cómo formula la necesidad tu audiencia y crea una URL que explique alcance, proceso, criterios de decisión, evidencia y siguiente paso sin repetir frases vacías.
El contenido es escaso, duplicado o poco diferenciador
Copiar textos de proveedores, crear variantes casi iguales por ciudad o publicar artículos sin experiencia propia dificulta que Google identifique una página claramente útil. Consolida duplicados y añade respuestas, ejemplos, datos, metodología o experiencia verificable.
La arquitectura y los enlaces internos son débiles
Si una página importante no recibe enlaces desde navegación, categorías o contenidos relacionados, Google puede tardar en descubrirla o interpretar que tiene poca prioridad. Utiliza enlaces HTML rastreables, textos ancla descriptivos y una jerarquía comprensible.
La web tiene problemas técnicos o de experiencia
Estados HTTP incorrectos, renderizado incompleto, lentitud, inestabilidad móvil, recursos bloqueados o una migración sin redirecciones pueden reducir la capacidad de rastrear, entender y usar el sitio. La solución debe medirse en páginas reales, no solo en la puntuación de una prueba aislada.
Falta autoridad y continuidad temática
En mercados competidos no basta con publicar una página una vez. El sitio necesita cubrir las preguntas relacionadas, mantener información vigente, conectar contenidos útiles y conseguir menciones legítimas. Esa evolución se construye y se mide durante meses.
Por qué el SEO recurrente va más allá de “indexar la web”
Una corrección técnica puede desbloquear el rastreo en un día, pero ganar visibilidad sostenible exige un sistema continuo. El comportamiento de búsqueda cambia, aparecen competidores, se publican nuevas URLs, otras pierden rendimiento y el negocio modifica su oferta. Sin seguimiento, es fácil volver a acumular páginas huérfanas, contenido desactualizado o señales técnicas contradictorias.
Un servicio SEO recurrente debería conectar al menos cinco frentes:
- Salud técnica: estados HTTP, robots, canonicals, sitemap, renderizado, rendimiento y alertas de indexación.
- Demanda real: consultas de Search Console, palabras clave, intención, mercado y oportunidades comerciales.
- Contenido: creación, actualización, consolidación y mejora de páginas con una función definida.
- Arquitectura y autoridad: enlaces internos, jerarquía, menciones y activos que merezcan ser citados.
- Medición: impresiones, clics, consultas, posiciones, leads y ventas, distinguiendo correlación de impacto probado.
En SEOMOS usamos Search Console como evidencia operativa, no como una lista de botones. Priorizamos las páginas que pueden aportar al negocio, documentamos cambios y revisamos si la visibilidad se convierte en oportunidades. Si necesitas pasar de una corrección puntual a un proceso continuo, puedes contarnos qué está ocurriendo con tu web.
Checklist para hacer la revisión en orden
- Confirma si la URL está indexada mediante Search Console y usa
site:solo como señal orientativa. - Abre
/robots.txty verifica que la ruta importante no esté bloqueada. - Comprueba meta robots, encabezados
X-Robots-Tag, estado HTTP y canonical. - Abre el sitemap y confirma que contiene la URL canónica correcta.
- Agrega y verifica la propiedad adecuada en Search Console.
- Envía el sitemap y corrige cualquier error de obtención o procesamiento.
- Inspecciona la URL exacta y ejecuta la prueba publicada.
- Solicita indexación solo cuando la página ya sea accesible, canónica y útil.
- Si está indexada pero no gana visibilidad, trabaja intención, contenido, enlazado, experiencia y autoridad.
- Mide consultas, clics y conversiones de forma recurrente para decidir la siguiente mejora.
Fuentes oficiales consultadas
- Introducción a robots.txt de Google Search Central.
- Cómo crear y enviar un sitemap.
- Cómo agregar una propiedad a Search Console.
- Verificación de la propiedad de un sitio.
- Informe de Sitemaps de Search Console.
- Inspeccionar y solucionar problemas de una página.
- Cómo solicitar a Google un nuevo rastreo.
- Cómo funcionan el rastreo, la indexación y los resultados.
Preguntas frecuentes sobre páginas que no aparecen en Google
¿Cuánto tarda una página web en aparecer en Google?
No existe un plazo garantizado. Una URL puede rastrearse en pocos días o tardar varias semanas. La velocidad depende de descubrimiento, enlaces, sitemap, capacidad del sitio y evaluación de Google. Solicitar indexación comunica el cambio, pero no obliga a incorporarlo.
¿Debo permitir todo en robots.txt para aparecer?
No. Puedes bloquear áreas sin valor para búsqueda, pero las páginas públicas importantes y los recursos necesarios para interpretarlas deben ser rastreables. Revisa cada regla según la arquitectura del sitio.
¿El sitemap.xml hace que Google indexe todas mis páginas?
No. El sitemap ayuda a descubrir URLs y comunica cuáles consideras canónicas, pero Google decide cuáles rastrea e indexa. El archivo debe mantenerse limpio y alineado con canonical, robots y estado HTTP.
¿Google Search Console es obligatorio?
No es obligatorio para aparecer, pero permite verificar el estado, enviar sitemaps, inspeccionar URLs, detectar problemas y medir consultas y clics. Trabajar sin Search Console limita mucho el diagnóstico.
¿Puedo solicitar indexación muchas veces?
Repetir la solicitud no acelera una página que conserva el mismo problema. Úsala después de publicar o corregir una URL importante y deja que sitemap, navegación y enlaces internos sostengan el descubrimiento normal.
¿Por qué mi web aparece al buscar la marca, pero no mis servicios?
Porque estar indexado no equivale a posicionar. Para búsquedas de servicios compites por relevancia, calidad, autoridad, experiencia y contexto. Debes analizar la intención y construir páginas capaces de responderla mejor.
¿Una etiqueta noindex y un bloqueo en robots.txt son lo mismo?
No. Robots.txt limita el rastreo; noindex indica que el contenido no debe aparecer en resultados. Para leer noindex, Google debe poder acceder a la página, por lo que combinar ambas directivas puede impedir que procese la instrucción.
¿SEOMOS puede ayudarme de forma recurrente?
Sí. Podemos diagnosticar la indexación y trabajar de forma recurrente la salud técnica, las oportunidades de búsqueda, los contenidos, el enlazado y la medición de resultados. Escríbenos desde la página de contacto para revisar el contexto y definir el alcance.